

Weltweiter Ausfall von Microsoft 365: Warum Resilienz Unabhängigkeit braucht
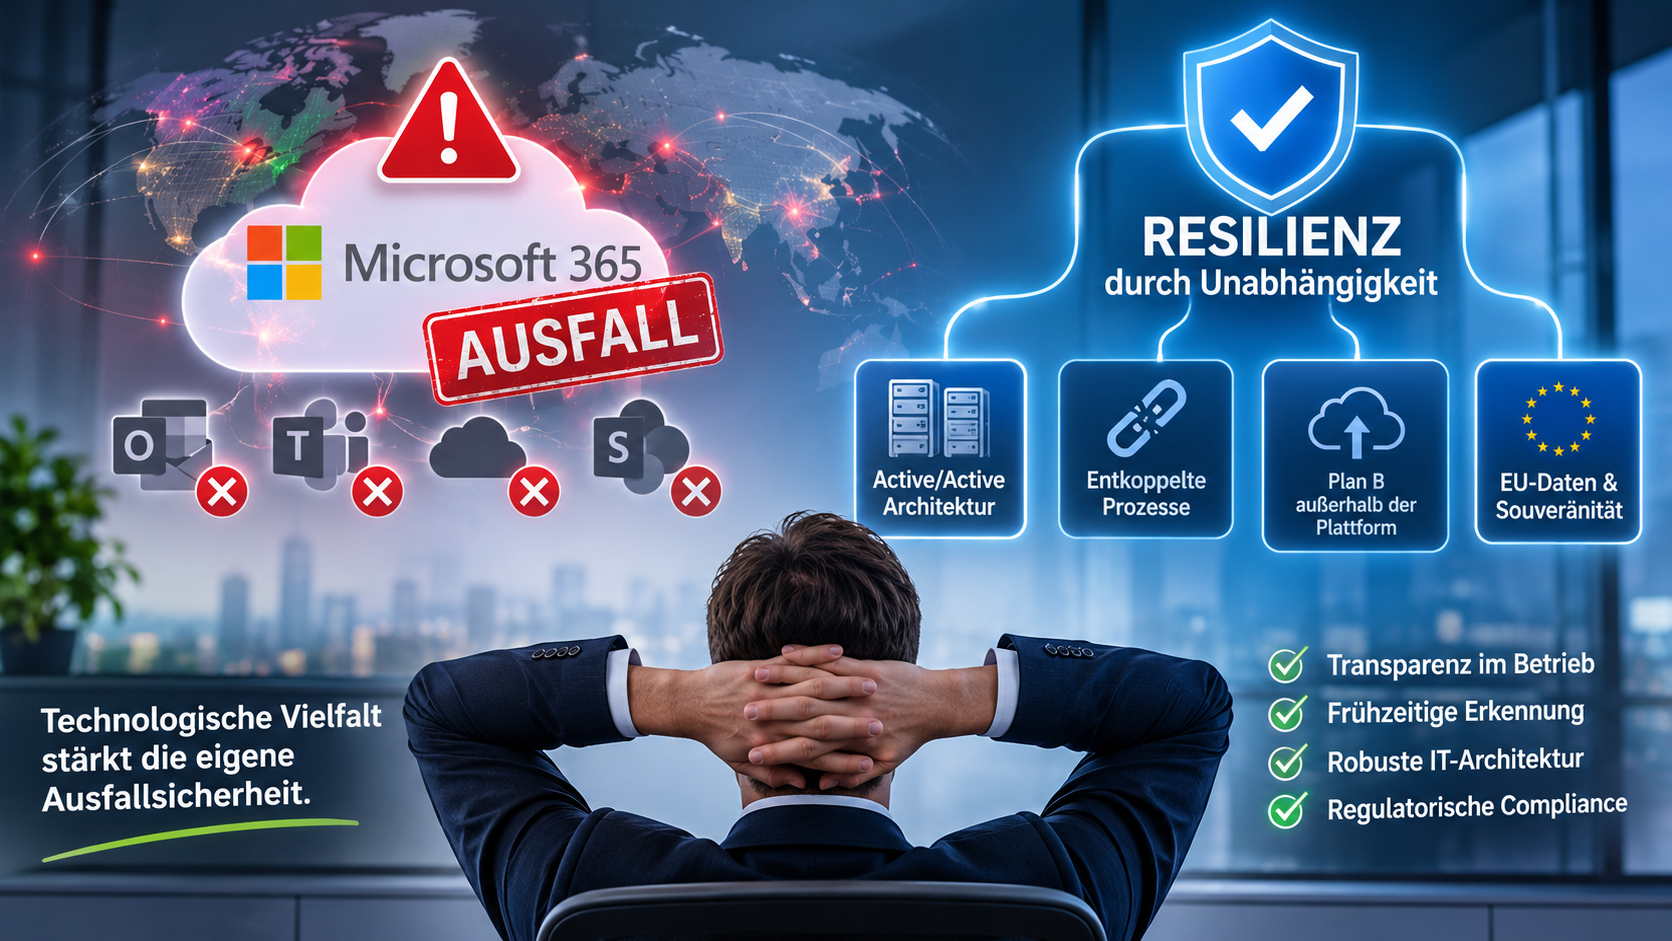
Der weltweite Ausfall von Microsoft 365 hat einmal mehr gezeigt, wie abhängig Unternehmen von einzelnen Technologieanbietern geworden sind. Die Störung sollte Anlass sein, die eigene IT-Resilienz kritisch zu überprüfen. Martin Hager, Gründer und CEO von Retarus, plädiert für mehr Transparenz im laufenden Betrieb, eine robuste und konsequent entkoppelte IT-Architektur sowie einen Notfallplan außerhalb der Plattform des Hauptanbieters. Denn technologische Monopole entstehen nicht zuletzt durch die Entscheidungen ihrer Kunden. Wer auf Vielfalt setzt, stärkt nicht nur den Wettbewerb, sondern auch die eigene Ausfallsicherheit.
Vergangene Woche waren zahlreiche Microsoft-365-Anwendungen, darunter Outlook und Teams, weltweit nicht verfügbar. Bereits im Vormonat hatte es eine größere Störung bei Microsofts Cloud-Plattform Azure gegeben. Solche Ausfälle lassen sich bei keinem Anbieter vollständig ausschließen. Entscheidend ist jedoch, welche Auswirkungen sie haben und wie weitreichend sie sind. Dass beim jüngsten Vorfall Kunden aus sämtlichen Bereichen und Regionen gleichzeitig betroffen waren, verdeutlicht das eigentliche Risiko. Wenn Consumer-, Enterprise- und Government-Dienste auf einer gemeinsamen, weltweit genutzten Plattform betrieben werden, bleibt für echte digitale Souveränität wenig Raum. Die wiederholten Störungen machen deutlich, wie wichtig technologische Unabhängigkeit und eine belastbare Ausfallsicherheit inzwischen sind.
Besonders kritisch sind solche Vorfälle, wenn sie die geschäftskritische E-Mail-Kommunikation betreffen. Selbst nachdem Microsoft die Verarbeitung von Nachrichten wieder aufgenommen hatte, kam es regional weiterhin zu erheblichen Verzögerungen.
Um auf solche Situationen angemessen reagieren zu können, müssen Unternehmen Störungen möglichst frühzeitig erkennen. Voraussetzung dafür ist ein transparenter Einblick in den Betriebszustand der genutzten Services. Relevante Betriebsdaten sollten in Echtzeit verfügbar sein und sich idealerweise unmittelbar in die unternehmenseigenen Monitoring-Systeme integrieren lassen.
Eine robuste Architektur begrenzt die Auswirkungen von Störungen
Viele Unternehmen vertrauen darauf, dass ihre Dienstleister ihre Infrastruktur über mehrere Rechenzentren verteilen. Das bietet Schutz vor dem Ausfall einzelner Server oder Standorte. Doch der jüngste Vorfall bei Microsoft hat gezeigt, dass diese Form der Redundanz allein nicht ausreicht. Als zahlreiche Systeme gleichzeitig ausfielen, mussten die verbleibenden Ressourcen zusätzliche Lasten auffangen und gerieten dadurch ebenfalls an ihre Grenzen.
Entscheidend ist daher nicht nur die Anzahl der Rechenzentren, sondern vor allem deren technische Unabhängigkeit. Autonome Rechenzentren mit jeweils eigener Netzinfrastruktur, die parallel aktiv sind und im Bedarfsfall die gesamte Last eigenständig übernehmen können, bieten ein deutlich höheres Maß an Ausfallsicherheit. Dieses Architekturprinzip wird als Active/Active bezeichnet.
Darüber hinaus sollten Unternehmen auf eine konsequente Entkopplung einzelner Prozesse achten. Eingehende und ausgehende Kommunikation sowie die Verteilung von Updates sollten möglichst unabhängig voneinander funktionieren. Eine asynchrone Verarbeitung verringert die Zahl systemübergreifender Abhängigkeiten und verhindert, dass sich lokale Störungen unkontrolliert auf weitere Dienste ausweiten.
Die größtmögliche Kontrolle bietet ein Anbieter, der seinen gesamten IT-Stack selbst entwickelt, besitzt und betreibt. Das ist zwar mit erheblichem technischem und finanziellem Aufwand verbunden, galt lange Zeit aber als übertriebene Vorsichtsmaßnahme. Spätestens angesichts der jüngsten Ausfälle wird deutlich: Eine solche Unabhängigkeit ist kein Luxus, sondern ein strategischer Vorteil.
Ein Notfallplan außerhalb der Hauptplattform
Doch auch eine redundante Infrastruktur innerhalb derselben Anbieterumgebung schafft noch keine echte Unabhängigkeit. Unternehmen benötigen deshalb zusätzlich einen Notfallbetrieb, der vollständig von der Plattform ihres Hauptanbieters getrennt ist.
Ein solches Ersatzsystem hält im Normalbetrieb wichtige Informationen wie Adressbücher und E-Mail-Verläufe kontinuierlich auf dem aktuellen Stand. Kommt es zu einem Ausfall der regulären Plattform, können Beschäftigte unmittelbar auf ihr Ersatzpostfach zugreifen – einfach über den Browser und auch mobil. Dabei bleiben sie unter ihren gewohnten E-Mail-Adressen erreichbar. Die geschäftliche Kommunikation kann somit auch dann weiterlaufen, wenn die primäre Plattform nicht verfügbar ist.
Allerdings kommt es auch hier auf die Wahl des Anbieters an. Wer seine Ausweichlösung bei einem weiteren großen Cloud-Anbieter aus demselben Rechtsraum betreibt, ersetzt möglicherweise nur eine Abhängigkeit durch eine andere. Mehr digitale Souveränität entsteht durch den Einsatz zertifizierter Rechenzentren innerhalb der EU und klare Regelungen, die einen unberechtigten Zugriff außereuropäischer Behörden ausschließen.
Gerade im Krisenfall zeigt sich, wie wichtig es ist, die Kontrolle über die eigene Kommunikationsinfrastruktur zu behalten.
Resilienz ist keine Kür, sondern eine Verpflichtung
Auch regulatorisch gewinnt das Thema an Bedeutung. Die NIS2-Richtlinie verpflichtet zahlreiche Unternehmen und Einrichtungen dazu, ihre Systeme und Kommunikationswege gegen Ausfälle und Cyberbedrohungen abzusichern. Für Finanzunternehmen stellt die DORA-Verordnung vergleichbare Anforderungen an die digitale operationelle Resilienz.
Der nächste größere IT-Ausfall ist keine Frage des Ob, sondern des Wann. Entscheidend ist deshalb, wie gut Unternehmen darauf vorbereitet sind. Wer Störungen frühzeitig erkennt, auf eine unabhängige und belastbare Architektur setzt und über einen funktionierenden Notbetrieb außerhalb der Hauptplattform verfügt, muss im Ernstfall nicht auf die Wiederherstellung durch seinen Anbieter warten. Genau darin liegt der Schlüssel zu echter digitaler Resilienz.
/ 0 Kommentare /
Melde dich an, um mitzudiskutieren.